显示图片
import torch                              # 导入 PyTorch 库,用于张量操作
import torch.nn.functional as F           # 导入 PyTorch 的函数式 API,包含各种神经网络函数
import numpy as np                        # 导入 NumPy 库,用于数值计算
import matplotlib as mpl                  # 导入 Matplotlib 库的主模块
import matplotlib.pyplot as plt           # 导入 Matplotlib 的绘图模块,用于显示图像
import imageio.v2 as imageio                            # 导入 imageio 库,用于读取图片文件

mpl.rcParams['figure.figsize'] = (12, 8)  # 设置 Matplotlib 图表默认尺寸为 12x8 英寸

img = torch.FloatTensor(imageio.imread('imgs/hills_2.png')/255)  # 读取图片,像素值归一化到[0,1],转为 PyTorch 浮点张量
print(type(img))
plt.imshow(img)                           # 使用 Matplotlib 显示图片
plt.show()
将上述文件保存为1.py,执行后将hills_2.png显示出来。

RGB一共有三个通道
R:Red(红色)
G:Green(绿色)
B:Blue(蓝色)
其取值范围为[0,255]
例如:
黑色:(0,0,0)
白色:(255,255,255)
红色:(255,0,0)
蓝色:(0,0,255)
如果图像尺寸是 𝐻×𝑊
常见 tensor 形状:
PyTorch:(3,𝐻,𝑊)
TensorFlow:(𝐻,𝑊,3)
对称处理
为了让数据和高斯噪声处在同一个零中心对称空间里,要对像素值进行仿射变换:
原像素值取值范围为[0,255]
归一化(就是除以255),取值范围为[0,1]
现在想它取值范围为[-1,1]
变换形式为$y=ax+b$
当$x=0$时,$y=-1$,当$x=1$时,$y=1$
$y=2x-1$,$x=\frac{1}{2}y+\frac{1}{2}$
仿射变换矩阵为:
$$ \begin{bmatrix} y \\ 1 \end{bmatrix} = \begin{bmatrix} 2 & -1 \\ 0 & 1 \end{bmatrix} \begin{bmatrix} x \\ 1 \end{bmatrix} $$
$$ \begin{bmatrix} x \\ 1 \end{bmatrix} = \begin{bmatrix} \frac{1}{2} & \frac{1}{2} \\ 0 & 1 \end{bmatrix} \begin{bmatrix} y \\ 1 \end{bmatrix} $$
写成代码2.py
import torch                              # 导入 PyTorch 库,用于张量操作
import torch.nn.functional as F           # 导入 PyTorch 的函数式 API,包含各种神经网络函数
import numpy as np                        # 导入 NumPy 库,用于数值计算
import matplotlib as mpl                  # 导入 Matplotlib 库的主模块
import matplotlib.pyplot as plt           # 导入 Matplotlib 的绘图模块,用于显示图像
import imageio.v2 as imageio                            # 导入 imageio 库,用于读取图片文件

mpl.rcParams['figure.figsize'] = (12, 8)  # 设置 Matplotlib 图表默认尺寸为 12x8 英寸

img = torch.FloatTensor(imageio.imread('imgs/hills_2.png')/255)  # 读取图片,像素值归一化到[0,1],转为 PyTorch 浮点张量
print(type(img))
                           # 使用 Matplotlib 显示图片
def input_T(input):
    # [0,1] -> [-1,+1]
    return 2*input-1

def output_T(input):
    # [-1,+1] -> [0,1]
    return (input+1)/2

def show(input):
    plt.imshow(output_T(input).clip(0,1))

img_=input_T(img)

plt.imshow(img_)

#show(img_)

plt.show()
这段代码改改玩,如果只进行变换,不进行逆变换
图片长这样

可以看出图片的形状没有变
扩散过程
扩散过程是基于一个方差调度表构建的,这个调度表决定了在扩散过程的每一个时间步中加入噪声的强度。为此,我们定义如下几个量:
- betas:$\betat$ * alphas:$\alphat = 1 - \betat$ * alphassqrt:$\sqrt{\alphat}$ * alphasprod:$\bar{\alpha}t = \prod{i=0}^{t}\alphai$ * alphasprodsqrt:$\sqrt{\bar{\alpha}t}$
1. betas:$\beta_t$
它表示第 $t$ 步加入噪声的强度,也可以理解为该步的“噪声方差比例”。
直观理解:
- $\betat$ 越大,这一步加入的随机噪声越多 * $\betat$ 越小,这一步对原图破坏得越轻
所以,$\beta_t$ 控制的是:
当前这一步要往图像里掺多少噪声。
- alphas:$\alphat = 1 - \betat$
它表示第 $t$ 步保留下来的原始信号比例。
直观理解:
因为每一步不是“全换成噪声”,而是:
- 保留一部分原信号
- 再加入一部分新噪声
所以:
- $\alphat$ 大,说明这一时刻保留原图信息更多 * $\alphat$ 小,说明这一时刻原图被削弱得更多
可以把它理解为:
这一轮之后,图像内容还能剩下多少。
- alphassqrt:$\sqrt{\alphat}$
这个量是在实际加噪公式里直接使用的系数。
单步扩散通常写成:
$$x_t = \sqrt{\alpha_t} \, x_{t-1} + \sqrt{1-\alpha_t} \, \epsilon_t$$
其中:
- $x{t-1}$ 是上一步图像 * $xt$ 是当前这一步加噪后的图像
- $\epsilon_t \sim \mathcal{N}(0, I)$ 是高斯噪声(符合高斯分布的噪声)
直观理解:
$\sqrt{\alpha_t}$ 是上一步图像在当前步中的保留权重。
之所以取平方根,是因为扩散模型里控制的是方差,而真正乘在样本上的系数是标准差,所以会出现平方根。
注:变量乘以标准差,才能得到对应的方差。如X⇒3X,方差是原来的9倍。
- alphasprod:$\bar{\alpha}t = \prod{i=0}^{t}\alphai$
它表示从第 $0$ 步到第 $t$ 步,所有保留比例连乘之后的结果。
直观理解:
如果每一步都保留一部分信号,那么经过很多步之后,原始图像 $x_0$ 还能剩多少,不是看某一步,而是看所有步骤累积起来的效果。
所以 $\bar{\alpha}_t$ 表示:
原始图像 $x_0$ 到第 $t$ 步时,整体还保留了多少比例的信号能量。
- 当 $t$ 很小时,$\bar{\alpha}t$ 还比较大,说明原图信息还比较多 * 当 $t$ 很大时,$\bar{\alpha}t$ 会变得很小,说明原图已经几乎被噪声淹没了
5. alphasprodsqrt:$\sqrt{\bar{\alpha}_t}$
这个量是从原图 $x_0$ 直接生成第 $t$ 步噪声图 $x_t$ 时的关键系数。
扩散模型里一个非常重要的公式是:
$$x_t = \sqrt{\bar{\alpha}_t} \, x_0 + \sqrt{1-\bar{\alpha}_t} \, \epsilon$$
直观理解:
这里:
- $\sqrt{\bar{\alpha}t}$ 控制原始图像 $x0$ 在 $xt$ 中还占多少 * $\sqrt{1-\bar{\alpha}t}$ 控制累计噪声占多少 所以 $\sqrt{\bar{\alpha}_t}$ 可以理解为: 从原图走到第 $t$ 步时,原图成分的缩放系数。 扩散过程本质上就是不断重复下面这件事: - 保留一部分当前图像 - 加入一点高斯噪声 - 重复很多次,直到图像几乎变成纯噪声 其中: * $\betat$:这一轮加多少噪声 * $\alphat$:这一轮保留多少信号 * $\sqrt{\alphat}$:这一轮信号实际乘上的系数 * $\bar{\alpha}t$:经过前 $t$ 步后,原图总共还剩多少 * $\sqrt{\bar{\alpha}_t}$:原图在第 $t$ 步中的实际缩放系数 最关键的两个公式 单步加噪 $$xt = \sqrt{\alphat} \, x{t-1} + \sqrt{1-\alphat} \, \epsilon_t$$ 表示从上一步 $x{t-1}$ 走到当前步 $xt$。 直接从原图采样到第 t 步 $$xt = \sqrt{\bar{\alpha}t} \, x0 + \sqrt{1-\bar{\alpha}t} \, \epsilon$$ 表示不用一步一步加,可以直接从原图 $x0$ 得到任意时刻 $xt$。 用代码表示为 <code> numtimesteps=1000 betas=torch.linspace(1e-4,2e-2,numtimesteps) alphas=1-betas alphassqrt=alphas.sqrt() alphascumprod=torch.cumprod(alphas,0) alphascumprodsqrt=alphas_cumprod.sqrt() </code> 前向过程 $q$ 决定了扩散过程中后续各步是如何得到的,也就是如何对原始样本 $x_0$ 进行逐步扰动。 首先,我们给出描述这一过程的关键公式。 前向过程的单步基本形式: $q(xt|x{t-1}) := \mathcal{N}(xt; \sqrt{1-\betat}x{t-1}, \betat I) \tag{1}$ ====== 前向过程单步公式讲解 ====== 1. 公式整体是什么意思 $q(xt|x{t-1})$ 表示一个条件概率分布,读作: “在给定 $x{t-1}$ 的条件下,$xt$ 的分布”。 这里: * $q$:表示前向扩散过程 * $x{t-1}$:第 $t-1$ 步的样本 * $xt$:第 $t$ 步的样本 也就是说,这个式子定义了: 如何从上一步的样本 $x{t-1}$ 随机生成当前步的样本 $xt$。 2. 符号 := 的含义 $q(xt|x{t-1}) := \mathcal{N}(\cdots)$ 这里的 $:=$ 表示: “定义为” 也就是说,不是在推导结论,而是在规定: 前向过程的单步转移分布就定义成右边这个高斯分布。 右边的 $\mathcal{N}$ 是什么 $\mathcal{N}(x_t;\mu,\Sigma)$ 表示一个高斯分布,其中: * 第一个位置 $x_t$:表示随机变量 * 第二个位置 $\mu$:表示均值 * 第三个位置 $\Sigma$:表示协方差矩阵 所以: $\mathcal{N}(xt;\sqrt{1-\betat}x{t-1},\betat I)$ 表示: $xt$ 服从一个均值为 $\sqrt{1-\betat}x{t-1}$、协方差为 $\betat I$ 的高斯分布。 4. 公式中每个位置分别表示什么 公式为: $q(xt|x{t-1}) := \mathcal{N}(xt;\sqrt{1-\betat}x{t-1},\betat I)$ 可以按位置拆成三部分: 第 1 个位置:$x_t$ 这是高斯分布里的随机变量。 意思是: 我们要描述的是 $x_t$ 这个量的分布。 也就是“当前步生成出来的样本是多少”。 第 2 个位置:$\sqrt{1-\betat}x{t-1}$ 这是高斯分布的均值。 意思是: $x_t$ 大致会围绕这个中心值波动。 其中: * $x{t-1}$:上一时刻的样本 * $\sqrt{1-\betat}$:对上一时刻样本的缩放系数 所以均值部分表示: 当前步会保留上一步的大部分信息,但会稍微缩小一点。 如果 $\beta_t$ 很小,那么: * $1-\betat$ 很接近 $1$ * $\sqrt{1-\betat}$ 也很接近 $1$ 说明当前步和上一步会很接近,只是稍微被扰动一点。 第 3 个位置:$\beta_t I$ 这是高斯分布的协方差矩阵。 其中: * $\beta_t$:控制噪声强度 * $I$:单位矩阵 $\beta_t I$ 的意思是: * 每个维度上的噪声方差都是 $\beta_t$ * 不同维度之间相互独立 如果是在图像里理解,就是: 每个像素或每个特征维度都被加上独立的高斯噪声。 5. 这个公式展开后是什么意思 这个分布形式可以等价地写成采样形式: $xt = \sqrt{1-\betat}x{t-1} + \sqrt{\betat}\,\epsilon_t$ 其中: $\epsilon_t \sim \mathcal{N}(0,I)$ 这就是这个公式最常见的“展开形式”。 从 $x0$ 直接跳到 $xt$ 的形式: $q(xt|x0) = \mathcal{N}(xt; \sqrt{\bar{\alpha}t}x0, (1-\bar{\alpha}t) I) \tag{2}$ 定义一个函数
forward_step()下面我们定义一个函数forward_step(),它可以让我们使用单步前向过程 $q(xt|x{t-1})$;同时再定义forward_jump(),用于表示从 $x0$ 直接到 $xt$ 的过程 $q(xt|x0)$。 <code> import torch # 导入 PyTorch 库,用于张量操作 import torch.nn.functional as F # 导入 PyTorch 的函数式 API,包含各种神经网络函数 import numpy as np # 导入 NumPy 库,用于数值计算 import matplotlib as mpl # 导入 Matplotlib 库的主模块 import matplotlib.pyplot as plt # 导入 Matplotlib 的绘图模块,用于显示图像 import imageio.v2 as imageio # 导入 imageio 库,用于读取图片文件 mpl.rcParams['figure.figsize'] = (12, 8) # 设置 Matplotlib 图表默认尺寸为 12×8 英寸 # 读取图片,像素值归一化到[0,1],转为 PyTorch 浮点张量 img = torch.FloatTensor(imageio.imread('imgs/hills_2.png')/255) print(type(img)) # 值域转换函数:将图像从 [0,1] 转换到 [-1,+1] def inputT(input): # [0,1] → [-1,+1] return 2*input-1
# 值域转换函数:将图像从 [-1,+1] 转换到 [0,1] def outputT(input): # [-1,+1] → [0,1] return (input+1)/2 # 显示图像函数,自动转换值域并裁剪到 [0,1] def show(input): plt.imshow(output_T(input).clip(0,1)) # ========== 扩散模型超参数设置 ========== T = 100 # 时间步总数 # 定义 beta 调度(线性调度) betas = torch.linspace(0.0001, 0.02, T) # 从 0.0001 线性增加到 0.02 # 计算 alpha 相关参数 alphas = 1 - betas # alphat = 1 - betat alphascumprod = torch.cumprod(alphas, dim=0) # 累积乘积:ᾱt = ∏(1-βs) alphascumprodsqrt = torch.sqrt(alphascumprod) # √ᾱt alphassqrt = torch.sqrt(alphas) # √α_t # ========== 加噪过程函数 ========== def forwardstep(t, conditionimg, return_noise=False): “”“ forward step: t-1 → t 单步加噪:从前一时刻 t-1 加噪到当前时刻 t ”“”
assert t >= 0 mean = alphassqrt[t] * conditionimg
std = betas[t].sqrt()
# sampling from N if not returnnoise: return mean + std * torch.randnlike(img) else: noise = torch.randnlike(img) return mean + std * noise, noise
def forwardjump(t, conditionimg, conditionidx=0, returnnoise=False): “”“ forward jump: 0 → t 直接跳转加噪:从初始时刻 0 直接加噪到时刻 t ”“”
assert t >= 0
mean = alphascumprodsqrt[t] * conditionimg std = (1 - alphascumprod[t]).sqrt()
# sampling from N if not returnnoise: return mean + std * torch.randnlike(img) else: noise = torch.randnlike(img) return mean + std * noise, noise # ========== 测试加噪过程 ========== if name == “main”: # 将图像转换到 [-1, 1] 值域 img_ = inputT(img)
# 测试 forwardjump:展示不同时间步的加噪效果 fig, axes = plt.subplots(2, 5, figsize=(15, 6))
# 显示原图 axes[0, 0].imshow(img) axes[0, 0].settitle('Original (t=0)') axes[0, 0].axis('off')
# 显示不同时间步的加噪结果 timesteps = [10, 30, 50, 70, 90, 20, 40, 60, 80, 99] for idx, t in enumerate(timesteps): row = idx 5 col = idx % 5 if row == 0 and col == 0: continue # 跳过原图位置 noisyimg = forwardjump(t, img) axes[row, col].imshow(outputT(noisyimg).clip(0, 1)) axes[row, col].settitle(f't={t}') axes[row, col].axis('off')
plt.tightlayout() plt.suptitle('Forward Diffusion Process (Jump)', y=1.02) plt.show()
# 测试 forwardstep:逐步加噪过程 fig, axes = plt.subplots(2, 5, figsize=(15, 6))
currentimg = img for t in range(10): row = t 5 col = t % 5 if t > 0: currentimg = forwardstep(t, currentimg) axes[row, col].imshow(outputT(currentimg).clip(0, 1)) axes[row, col].settitle(f'Step t={t}') axes[row, col].axis('off')
plt.tightlayout() plt.suptitle('Forward Diffusion Process (Step by Step)', y=1.02) plt.show()
print(“加噪过程测试完成!”) </code>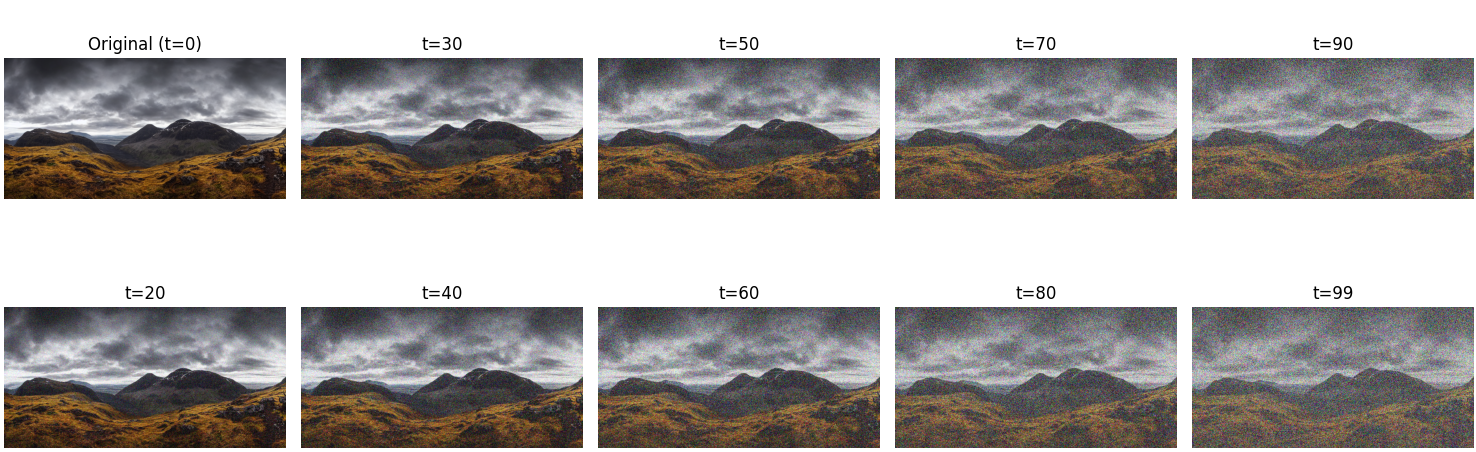 ====== 反向过程 ======
反向过程 $p$ 的目的是:根据扩散链中的当前样本 $xt$,去近似恢复前一步的样本 $x{t-1}$。在实际情况下,这种近似 $p(x{t-1}|xt)$ 必须在不知道 $x_0$ 的前提下完成。
通常会使用一个带参数 $\theta$ 的可参数化预测模型,来估计 $p\theta(x{t-1}|x_t)$。
如果扩散的每一步足够小,那么反向过程也可以近似看作高斯分布:
$$p\theta(x{t-1}|xt) := \mathcal{N}(x{t-1};\mu\theta(xt),\Sigma\theta(xt))\tag{3}$$
在很多工作中,通常假设这个分布的方差不应强烈依赖于 $x0$ 或 $xt$,而应主要依赖于扩散过程所处的阶段 $t$。这一点可以从真实分布 $q(x{t-1}|xt, x0)$ 中观察到,因为该分布的方差等于 $\tilde{\beta}t$。
对 $\mu_\theta$ 的参数化
对于反向单步分布 $p\theta(x{t-1}|xt)$ 的均值 $\mu\theta$,至少有 3 种参数化方式:
* 直接预测:由神经网络直接估计 $\mu\theta$
* 通过 $x0$ 参数化:由神经网络先估计 $x_0$
$$\tilde{\mu}\theta = \frac{\sqrt{\bar{\alpha}{t-1}}\betat}{1-\bar{\alpha}t}x0 + \frac{\sqrt{\alphat}(1-\bar{\alpha}{t-1})}{1-\bar{\alpha}t}x_t\tag{4}$$
* 通过从 $x_0$ 中减去噪声 $\epsilon$ 来参数化:由神经网络估计 $\epsilon$
$$x0=\frac{1}{\sqrt{\bar{\alpha}t}}(xt-\sqrt{1-\bar{\alpha}t}\epsilon)\tag{5}$$
其中,最常用的方法是近似预测高斯噪声 $\epsilon$。
下面我们来看一个 $\epsilon$ 的示例可能长什么样:
<code>
import torch # 导入 PyTorch 库,用于张量操作
import torch.nn.functional as F # 导入 PyTorch 的函数式 API
import numpy as np # 导入 NumPy 库,用于数值计算
import matplotlib as mpl # 导入 Matplotlib 库的主模块
import matplotlib.pyplot as plt # 导入 Matplotlib 的绘图模块
import imageio.v2 as imageio # 导入 imageio 库,用于读取图片文件
mpl.rcParams['figure.figsize'] = (12, 8) # 设置 Matplotlib 图表默认尺寸
# 读取图片,像素值归一化到[0,1],转为 PyTorch 浮点张量
img = torch.FloatTensor(imageio.imread('imgs/hills_2.png') / 255)
# 值域转换函数:将图像从 [0,1] 转换到 [-1,+1](扩散模型标准输入值域)
def input_T(input):
# [0,1] → [-1,+1]
return 2 * input - 1
# 值域转换函数:将图像从 [-1,+1] 转换到 [0,1](用于显示)
def output_T(input):
# [-1,+1] → [0,1]
return (input + 1) / 2
# 显示图像函数,自动转换值域并裁剪到 [0,1]
def show(input):
plt.imshow(output_T(input).clip(0, 1))
# ========== 扩散模型超参数设置 ==========
T = 100 # 时间步总数
# 定义 beta 调度(线性调度)
betas = torch.linspace(0.0001, 0.02, T) # 从 0.0001 线性增加到 0.02
# 计算 alpha 相关参数
alphas = 1 - betas # alphat = 1 - betat
alphascumprod = torch.cumprod(alphas, dim=0) # 累积乘积:ᾱt = ∏(1-βs)
alphascumprodsqrt = torch.sqrt(alphascumprod) # √ᾱ_t
# 设置前向跳转的时间步
t_step = 50
def forwardjump(t, conditionimg, conditionidx=0, returnnoise=False):
“”“
forward jump: 0 → t
直接跳转加噪:从初始时刻 0 直接加噪到时刻 t
根据扩散模型公式:xt = √ᾱt * x0 + √(1-ᾱt) * ε 其中 ε ~ N(0, I) ”“” assert t >= 0 mean = alphascumprodsqrt[t] * conditionimg std = (1 - alphascumprod[t]).sqrt() # 从正态分布采样 if not returnnoise: return mean + std * torch.randnlike(conditionimg) else: noise = torch.randnlike(condition_img) return mean + std * noise, noise # ========== 主程序 ========== if name == “main”: # 将图像转换到 [-1, 1] 值域 img_ = input_T(img) # 执行前向跳转加噪,获取加噪后的图像和噪声 xt, noise = forwardjump(tstep, img, return_noise=True) # 可视化结果 plt.subplot(1, 3, 1) show(img) plt.title(r'$x0$') plt.axis('off') plt.subplot(1, 3, 2) show(xt) plt.title(r'$xt$') plt.axis('off') plt.subplot(1, 3, 3) show(noise) plt.title(r'$\epsilon$') plt.axis('off') plt.suptitle(f'Forward Diffusion Process (t={tstep})', y=0.98) plt.tightlayout() plt.show() </code>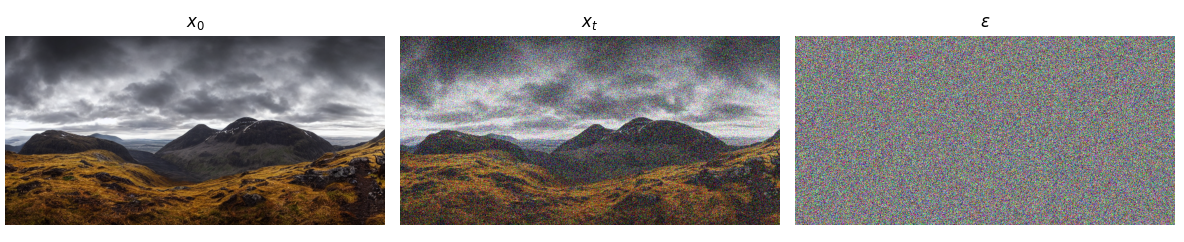 如果噪声 $\epsilon$ 能够被正确预测,那么我们就可以利用公式 $x0=\frac{1}{\sqrt{\bar{\alpha}t}}(xt-\sqrt{1-\bar{\alpha}t}\epsilon)$来预测 $x_0$:
<code python>
import torch # 导入 PyTorch 库,用于张量操作
import torch.nn.functional as F # 导入 PyTorch 的函数式 API
import numpy as np # 导入 NumPy 库,用于数值计算
import matplotlib as mpl # 导入 Matplotlib 库的主模块
import matplotlib.pyplot as plt # 导入 Matplotlib 的绘图模块
import imageio.v2 as imageio # 导入 imageio 库,用于读取图片文件
mpl.rcParams['figure.figsize'] = (12, 8) # 设置 Matplotlib 图表默认尺寸
# 读取图片,像素值归一化到[0,1],转为 PyTorch 浮点张量
img = torch.FloatTensor(imageio.imread('imgs/hills_2.png') / 255)
# 值域转换函数:将图像从 [0,1] 转换到 [-1,+1](扩散模型标准输入值域)
def input_T(input):
# [0,1] → [-1,+1]
return 2 * input - 1
# 值域转换函数:将图像从 [-1,+1] 转换到 [0,1](用于显示)
def output_T(input):
# [-1,+1] → [0,1]
return (input + 1) / 2
# 显示图像函数,自动转换值域并裁剪到 [0,1]
def show(input):
plt.imshow(output_T(input).clip(0, 1))
# ========== 扩散模型超参数设置 ==========
T = 100 # 时间步总数
# 定义 beta 调度(线性调度)
betas = torch.linspace(0.0001, 0.02, T) # 从 0.0001 线性增加到 0.02
# 计算 alpha 相关参数
alphas = 1 - betas # alphat = 1 - betat
alphascumprod = torch.cumprod(alphas, dim=0) # 累积乘积:ᾱt = ∏(1-βs)
alphascumprodsqrt = torch.sqrt(alphascumprod) # √ᾱ_t
# 设置前向跳转的时间步
t_step = 50
def forwardjump(t, conditionimg, returnnoise=False):
“”“
forward jump: 0 → t
直接跳转加噪:从初始时刻 0 直接加噪到时刻 t
根据扩散模型公式:xt = √ᾱt * x0 + √(1-ᾱ_t) * ε 其中 ε ~ N(0, I) ”“” assert t >= 0 mean = alphascumprodsqrt[t] * conditionimg std = (1 - alphascumprod[t]).sqrt() # 从正态分布采样 if not returnnoise: return mean + std * torch.randnlike(conditionimg) else: noise = torch.randnlike(condition_img) return mean + std * noise, noise # ========== 主程序 ========== if name == “main”: # 将图像转换到 [-1, 1] 值域 img_ = input_T(img) # 执行前向跳转加噪,获取加噪后的图像和噪声 xt, noise = forwardjump(tstep, img, return_noise=True) # 根据 xt 和噪声预测 x0 # 由 xt = √ᾱt * x0 + √(1-ᾱt) * ε 可得: # x0 = (xt - √(1-ᾱt) * ε) / √ᾱt x0pred = (xt - (1 - alphascumprod[tstep]).sqrt() * noise) / alphascumprodsqrt[tstep] # 可视化结果:xt(加噪图像)、x0 预测值、原始 x0 plt.subplot(1, 3, 1) show(xt) plt.title(r'$xt$ ($\ell1$: {:.3f})'.format(F.l1loss(xt, img_))) plt.axis('off') plt.subplot(1, 3, 2) show(x0pred) plt.title(r'$x0$ prediction ($\ell1$: {:.3f})'.format(F.l1loss(x0pred, img))) plt.axis('off') plt.subplot(1, 3, 3) show(img) plt.title(r'$x0$') plt.axis('off') plt.suptitle(f'x0 Prediction from xt (t={tstep})', y=0.98) plt.tightlayout() plt.show() </code>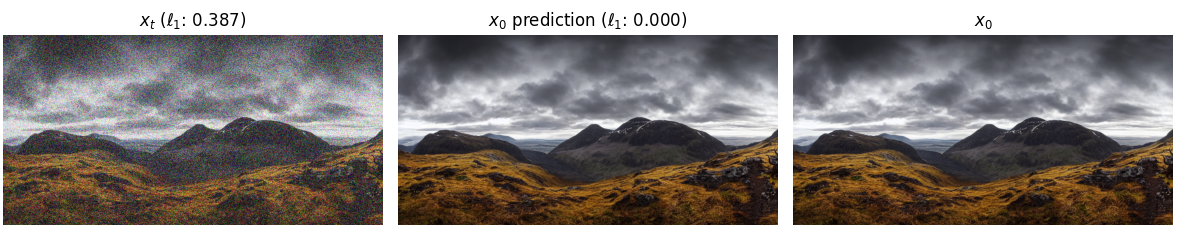 这里的含义是:
* 第一幅图显示当前带噪样本 $xt$
* 第二幅图显示根据预测噪声反推出的 $x0$,记作 $x0_pred$
* 第三幅图显示真实的干净样本 $x0$
如果预测的噪声足够准确,那么 $x0_pred$ 就会接近真实的 $x0$。
近似或已知 $x_0$ 后,可以进一步近似 $t-1$ 步的均值
一旦我们得到了对 $x0$ 的近似(或者直接知道真实的 $x0$),就可以利用公式 (4) 来近似第 $t-1$ 步对应分布的均值:
<code python>
# estimate mean
meanpred = x0pred * (alphascumprodsqrt[tstep-1] * betas[tstep]) / (1 - alphascumprod[tstep]) \
+ xt * (alphassqrt[tstep] * (1 - alphascumprod[tstep-1])) / (1 - alphascumprod[tstep])
# let's compare it to ground truth mean of the previous step (requires knowledge of x0)
meangt = alphascumprodsqrt[tstep-1] * img
</code>
其中:
*
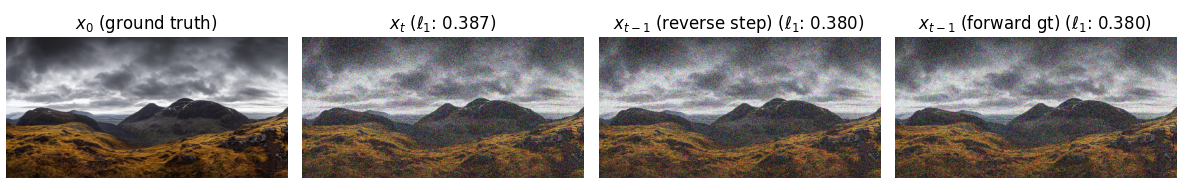
mean_pred:根据预测得到的 $x0$ 和当前样本 $xt$ 计算出的反向过程均值近似 *mean_gt:真实的前一步均值,它需要知道真实的 $x_0$ 这里的mean_gt本质上对应的是前向过程中从干净图像得到的“真实均值”。 —- 为什么mean_pred的误差通常会更大 由于公式 (4) 中的反向过程均值估计 $\tilde{\mu}\theta$,本质上是对带噪的 $xt$ 和估计出来的 $x_0$ 做一种线性组合,因此它通常会比前向过程直接得到的均值误差更大。 原因是: * $xt$ 本身仍然含有噪声 * $x0_pred$ 只是估计值,不是真实值 * 因此两者线性组合得到的均值仍然会带来额外误差 而前向过程中的均值通常只是对干净样本乘上一个标量,因此更精确。 下面的代码展示了这种比较: <code python> plt.subplot(1,3,1) show(xt) plt.title('$xt$ ($\ell1$: {:.3f})'.format(F.l1loss(xt, img))) plt.subplot(1,3,2) show(meanpred) plt.title(r'$\tilde{\mu}{t-1}$' + ' ($\ell1$: {:.3f})'.format(F.l1loss(meanpred, img))) plt.subplot(1,3,3) show(meangt) plt.title(r'$\mu{t-1}$' + ' ($\ell1$: {:.3f})'.format(F.l1loss(meangt, img))) </code>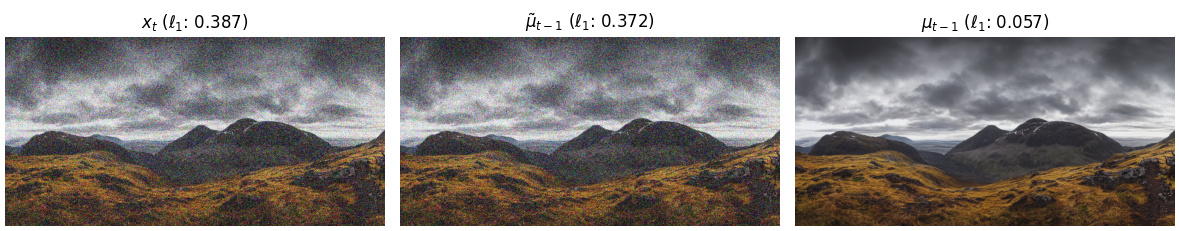 这三幅图分别表示:
* 左图:当前带噪图像 $xt$
* 中图:反向过程估计的均值 $\tilde{\mu}{t-1}$
* 右图:真实均值 $\mu_{t-1}$
比较它们的 $\ell_1$ 误差,就可以看出估计值和真实值之间的差别。
—-
得到
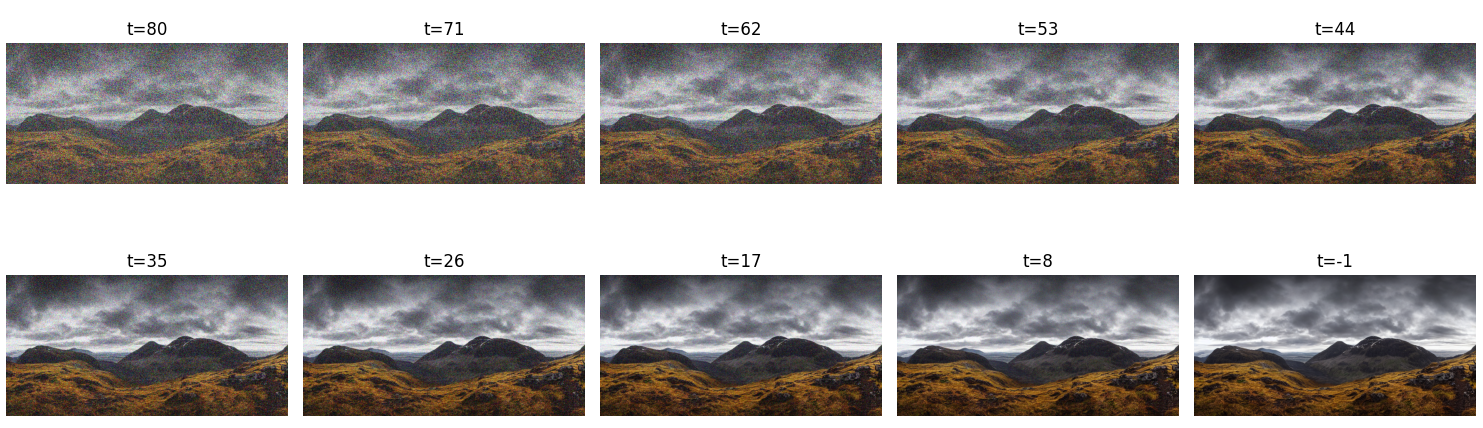
mean_pred之后,就可以定义前一步的分布 当我们获得了mean_pred,也就是 $\tilde{\mu}_t$ 之后,就可以将前一步的条件分布定义为: $$\tilde{\beta}t = \betat \tag{6}$$ $$p\theta(x{t-1}|xt) := \mathcal{N}(x{t-1}; \tilde{\mu}\theta(xt,t), \tilde{\beta}_t I) \tag{7}$$ 这个定义表示: * 均值使用网络估计出来的 $\tilde{\mu}\theta(xt,t)$ * 方差使用 $\tilde{\beta}_t$ * 从而构造出反向过程中的高斯分布 重要说明 > 下面的实验应被看作一种模拟。 > 在实际训练和推理中,网络必须预测以下三者之一: > * $\epsilon$ > * $x0$ > * $\tilde{\mu}\theta$ > > 而这里的 $\epsilon$ 值只是直接代入使用的,并不是真实模型预测出来的结果。reverse_step函数 下面这个函数实现了一次反向扩散步骤: <code python> def reversestep(epsilon, xt, tstep, returnnoise=False):
# estimate x0 based on epsilon x0pred = (xt - (1 - alphascumprod[tstep]).sqrt() * epsilon) / (alphascumprodsqrt[t_step]) if tstep == 0: sample = x0pred noise = torch.zeroslike(x0pred) else: # estimate mean meanpred = x0pred * (alphascumprodsqrt[tstep-1] * betas[tstep]) / (1 - alphascumprod[tstep]) \ + xt * (alphassqrt[tstep] * (1 - alphascumprod[tstep-1])) / (1 - alphascumprod[tstep]) # compute variance betapred = betas[tstep].sqrt() if t_step != 0 else 0 sample = meanpred + betapred * torch.randnlike(xt) # this noise is only computed for simulation purposes (since x0pred is not known normally) noise = (sample - x0pred * alphascumprodsqrt[tstep-1]) / (1 - alphascumprod[t_step-1]).sqrt() if return_noise: return sample, noise else: return sample </code> —-reverse_step()的逻辑讲解 1. 根据 $\epsilon$ 先恢复 $x_0$ <code python> x0pred = (xt - (1 - alphascumprod[tstep]).sqrt() * epsilon) / (alphascumprodsqrt[tstep]) </code> 这一行对应公式 (5): $$x0=\frac{1}{\sqrt{\bar{\alpha}t}}(xt-\sqrt{1-\bar{\alpha}t}\epsilon)$$ 作用是: * 输入当前带噪样本 $xt$ * 输入预测得到的噪声 $\epsilon$ * 反推出干净图像的估计值 $x0$ —- 2. 如果已经到达 $t=0$ <code python> if tstep == 0: sample = x0pred noise = torch.zeroslike(x_0_pred) </code> 当t_step == 0时,说明已经到达反向过程的最后一步,不需要再继续去噪。 因此: * 直接把 $x_0_pred$ 当作最终结果 * 此时噪声设为全零 —- 3. 如果 $t > 0$,先估计反向均值 <code python> meanpred = x0pred * (alphascumprodsqrt[tstep-1] * betas[tstep]) / (1 - alphascumprod[tstep]) \ + xt * (alphassqrt[tstep] * (1 - alphascumprod[tstep-1])) / (1 - alphascumprod[tstep]) </code> 这一行对应公式 (4): $$\tilde{\mu}\theta = \frac{\sqrt{\bar{\alpha}{t-1}}\betat}{1-\bar{\alpha}t}x0 + \frac{\sqrt{\alphat}(1-\bar{\alpha}{t-1})}{1-\bar{\alpha}t}x_t$$ 只不过代码里用的是预测值x_0_pred来代替真实的 $x_0$。 意思是: * 综合当前带噪样本 $xt$ * 再结合恢复出的干净样本估计 $x0_pred$ * 得到前一步分布的均值估计mean_pred—- 4. 计算标准差 <code python> betapred = betas[tstep].sqrt() if t_step != 0 else 0 </code> 这里使用: * 方差 $\tilde{\beta}t = \betat$ * 所以标准差为 $\sqrt{\beta_t}$ 这是为了后面从高斯分布中采样: $$x{t-1} \sim \mathcal{N}(\tilde{\mu}\theta, \tilde{\beta}_t I)$$ —- 5. 从反向分布中采样 <code python> sample = meanpred + betapred * torch.randnlike(xt) </code> 这一步就是从高斯分布中真正采样出 $x_{t-1}$。 也就是: * 均值为mean_pred* 标准差为beta_pred* 加上一份标准高斯噪声 对应采样形式可以写成: $$x{t-1} = \tilde{\mu}\theta + \sqrt{\tilde{\beta}_t}\,z,\quad z\sim\mathcal{N}(0,I)$$ —- 6. 计算noise仅用于模拟分析 <code python> noise = (sample - x0pred * alphascumprodsqrt[tstep-1]) / (1 - alphascumprod[t_step-1]).sqrt() </code> 这里的noise只是为了实验分析而额外算出来的。 因为在真实的反向扩散推理中: * 我们并不知道真实的 $x0$ * 这里只是因为做实验,才利用x_0_pred反推一个噪声值 所以注释里才特别说明: * 这个噪声只是为了模拟目的而计算 * 并不是实际系统中能直接获得的量 7. 是否返回噪声 <code python> if returnnoise: return sample, noise else: return sample </code> 如果return_noise=True: * 返回当前反向步骤采样结果sample* 同时返回额外计算的noise否则: * 只返回sample这个reverse_step()函数做的事情是: * 先根据预测噪声 $\epsilon$ 还原出 $x0$ * 再根据 $xt$ 和 $x0$ 的估计值计算反向分布均值 * 然后从这个高斯分布中采样得到 $x{t-1}$ 也就是说,它实现了扩散模型中的一次“去噪反推”。